Macht lizenzierte KI-Musik die Musik zum Einheitsbrei?
Suno V6 setzt erstmals auf lizenzierte Trainingsdaten. Gleichzeitig kritisieren Nutzer den neuen Sound als generischer. Droht KI-Musik zum Mainstream-Einheitsbrei zu werden?

Es ist eine der paradoxesten Entwicklungen der aktuellen KI-Musikszene: Endlich kommen Modelle, die mit lizenzierten Musikdaten trainiert werden. Und ausgerechnet jetzt beschweren sich einige Nutzer darüber, dass die Ergebnisse weniger kreativ, weniger eigenwillig und austauschbarer klingen.
Was wäre, wenn die Musik-KI endlich das bekommt, was die Musikindustrie seit Jahren fordert – und dadurch einen Teil ihrer musikalischen Freiheit verliert?
Genau diese Frage drängt sich derzeit bei Suno V6 auf. Anfang September hat Suno eine neue Generation seiner Musikmodelle vorgestellt. V6, V6-Wild und V6-mini wurden von Grund auf neu entwickelt. Anders als die früheren Modelle sollen sie nicht auf denselben Datensätzen basieren, sondern auf einer Kombination aus lizenzierten Musikdaten und User-Daten. Zu den lizenzierten Katalogen gehören Aufnahmen aus Partnerschaften mit Warner Music Group und BMG.
Damit vollzieht Suno einen entscheidenden Kurswechsel. Doch kaum ist V6 da, taucht eine unerwartete Kritik auf: Einige Nutzer finden die neue Musik schlechter. Und nicht nur schlechter. Sie finden sie generischer.
Von „alles im Internet“ zu lizenzierten Katalogen
Um zu verstehen, warum diese Diskussion überhaupt entsteht, muss man einen Schritt zurückgehen. Die frühen Generationen von Musik-KI wurden mit riesigen Mengen an Musik trainiert. Bei Suno war die Datenbasis laut früheren eigenen Angaben besonders umfangreich; MusicRadar berichtete zudem über Daten, die auf eine massive Sammlung von Material aus YouTube Music, Deezer, Genius und Stock-Musikplattformen hindeuten. MusicRadar
Die rechtliche Frage war entsprechend gewaltig. Darf ein Unternehmen urheberrechtlich geschützte Musik kopieren und zum Training eines kommerziellen KI-Modells verwenden? Darüber streiten Suno und die Musikindustrie bis heute. Inzwischen ist die Richtung klarer: Lizenzieren statt einfach nehmen.
Warner Music und BMG gehören zu den Partnern, deren Musik in die Entwicklung der neuen Modelle einfließt. Auch Believe und dessen Plattform TuneCore sind Teil des neuen Suno-Ökosystems. Künstler und Rechteinhaber, die sich beteiligen, sollen dafür vergütet werden. MusicRadar+1
Aus Sicht der Rechtefrage ist das ein wichtiger Schritt. Musikalisch entsteht dadurch allerdings eine neue Frage.
Was passiert mit der Vielfalt?
Stell dir vor, du willst eine KI trainieren, die möglichst viele verschiedene Arten von Musik versteht. Du könntest ihr theoretisch eine gigantische Auswahl geben:
Jazz aus den 1950ern.
Underground-Techno.
Death Metal.
Afrobeat.
Experimentelle Elektronik.
Obskuren Folk.
Noise.
Punk-Demos.
Regionalmusik.
Independent-Releases.
Soundtracks.
Bedroom-Pop.
Musik, die kaum jemand kennt. Je größer und vielfältiger der Datensatz, desto mehr musikalische Kombinationen könnte ein Modell theoretisch kennenlernen. Aber was passiert, wenn du diesen Datensatz stark einschränkst? Nicht mehr „alles, was irgendwo im Internet verfügbar ist“. Sondern: Musik, für die bestimmte Rechteinhaber Lizenzen vergeben haben. Das ist rechtlich wesentlich sauberer. Aber möglicherweise auch eine andere musikalische Welt. Und genau hier beginnt die interessante Debatte.
Suno V6 sorgt bei Nutzern für Kritik
Kurz nach dem Start von V6 tauchten in der Suno-Community zahlreiche kritische Reaktionen auf. MusicRadar berichtet von Nutzern, die die neue Version als klanglich schlechter, weniger kreativ oder austauschbarer empfinden. Genannt werden unter anderem ein dumpferer Sound, weniger Dynamik und fehlende Überraschungsmomente. Auch auf Reddit ist die Kritik deutlich sichtbar. Einige Nutzer berichten von einem stärker komprimierten und weniger individuellen Klang und vergleichen V6 negativ mit älteren Suno-Modellen. Andere beklagen, dass frühere Modelle, die sie kreativer fanden, mit dem V6-Start eingestellt wurden. Das ist zunächst einmal genau das: Nutzerkritik.
Kein wissenschaftlicher Beweis. Es gibt bislang keine belastbare Untersuchung, die zeigen würde, dass lizenzierte Trainingsdaten grundsätzlich zu weniger kreativer Musik führen. Und auch Suno selbst beschreibt V6 ausdrücklich als leistungsfähiger, ausdrucksstärker und qualitativ besser als frühere Generationen. Trotzdem ist die Beobachtung interessant. Denn sie stellt eine Frage, die weit über Suno hinausgeht.
Vielleicht ist das Problem gar nicht die Lizenzierung
Es wäre zu einfach, zu sagen: „Lizenzierte Musik = schlechtere KI.“
Dafür gibt es derzeit keine ausreichenden Belege. Ein Modell kann aus vielen Gründen anders klingen. Die Trainingsmenge könnte kleiner sein. Die Daten könnten anders gewichtet werden. Bestimmte Musikarten könnten stärker oder schwächer vertreten sein. Das Modell könnte anders optimiert worden sein.
Auch Post-Processing, Audioqualität und die Art, wie ein Modell musikalische Strukturen verarbeitet, spielen eine Rolle. Und V6 ist ein komplett neu trainiertes Modell. Es wäre deshalb voreilig, die aktuelle Nutzerkritik allein auf die Herkunft der Trainingsdaten zurückzuführen.
Aber es gibt eine andere Frage, die sich durchaus stellen lässt: Wie vielfältig ist ein lizenzierter Datensatz tatsächlich?
Wer entscheidet, was in die KI kommt?
Das könnte langfristig der entscheidende Punkt werden. Wenn eine KI auf Musik trainiert wird, die von großen Rechteinhabern lizenziert wurde, haben diese Rechteinhaber zwangsläufig Einfluss darauf, welche Musik zur Verfügung steht. Das muss nicht automatisch schlecht sein.
Warner und BMG besitzen riesige und historisch äußerst vielfältige Kataloge. Aber sie repräsentieren trotzdem nicht die gesamte Musikgeschichte. Und schon gar nicht jede musikalische Nische.Die spannende Frage lautet deshalb „Wie vielfältig muss ein Trainingsdatensatz sein, damit eine KI musikalische Vielfalt erhalten kann?“
Darauf gibt es bislang keine einfache Antwort.
Der Underground könnte zum Problem werden
Nehmen wir ein extremes Beispiel. Ein Produzent möchte eine KI dazu bringen, eine Mischung aus frühem Detroit Techno, japanischem Noise, westafrikanischen Rhythmen und obskurem Krautrock zu erzeugen. Wenn all diese musikalischen Einflüsse in den Trainingsdaten vertreten sind, kann ein Modell theoretisch Zusammenhänge zwischen ihnen lernen.
Sind bestimmte Bereiche dagegen kaum vertreten, wird es schwieriger. Das bedeutet nicht, dass eine KI diese Musik nicht erzeugen kann.Aber ihre Vorstellung davon, wie solche Genres miteinander funktionieren, könnte eingeschränkter sein. Und genau hier liegt eine mögliche Gefahr: Nicht die KI wird automatisch schlechter – sondern ihre musikalische Welt könnte kleiner werden. Das ist ein Unterschied.
Der Mainstream hat einen Vorteil
Es gibt noch einen weiteren Effekt. Populäre Musik ist leichter zu lizenzieren.
Sie hat bekannte Rechteinhaber.
Es gibt etablierte Verwertungsketten.
Labels, Publisher und Distributoren können Verträge schließen.
Bei Millionen kleiner Independent-Releases, Underground-Produktionen und historischer Musik sieht die Situation wesentlich komplizierter aus. Wenn zukünftige KI-Modelle überwiegend auf professionell lizenzierten Katalogen großer Rechteinhaber basieren, könnte dadurch ein Ungleichgewicht entstehen: Das, was kommerziell gut organisiert und lizenzierbar ist, könnte überproportional stark in den Trainingsdaten vertreten sein.
Und das wäre tatsächlich eine interessante Form von musikalischem Bias. Nicht unbedingt: „Die KI kopiert den Mainstream.“
Sondern eher: „Die KI kennt den Mainstream besonders gut.“
Das könnte erklären, warum KI-Musik oft so vertraut klingt
Das Problem ist ohnehin nicht neu. Viele Nutzer beschreiben generative Musik als erstaunlich professionell – und gleichzeitig als vorhersehbar. Songs funktionieren. Produktionen klingen sauber. Arrangements sind plausibel. Vocals sitzen.
Aber manchmal fehlt genau das, was Musik interessant macht: der Fehler.
Die ungewöhnliche Entscheidung.
Der seltsame Sound.
Der Bruch.
Die schlechte Idee, die plötzlich funktioniert.
Die Produktion, die sich nicht an die Regeln hält.
Die musikalische Nische, die nie für den Mainstream gedacht war.
Und genau diese Elemente könnten für KI-Modelle schwieriger sein. Nicht weil sie „verboten“ wären. Sondern weil sie im Verhältnis zur Masse erfolgreicher Musik schlicht seltener vorkommen.
Überraschung ist schwer zu trainieren
Hier liegt möglicherweise ein grundlegendes Problem generativer Musik. Ein Modell wird darauf optimiert, musikalische Muster zu erkennen und überzeugende Ergebnisse zu erzeugen. Das bedeutet zwangsläufig eine gewisse Orientierung an dem, was es gelernt hat. Wenn die Daten sehr homogen sind, können auch die Ergebnisse homogener werden. Das ist kein exklusives Problem von Suno.
Es betrifft prinzipiell jedes generative System. Die Frage ist daher: Wie baut man ein Modell, das gleichzeitig musikalisch kompetent und wirklich überraschend ist? Das könnte eine der großen technischen Herausforderungen der nächsten Generation werden.
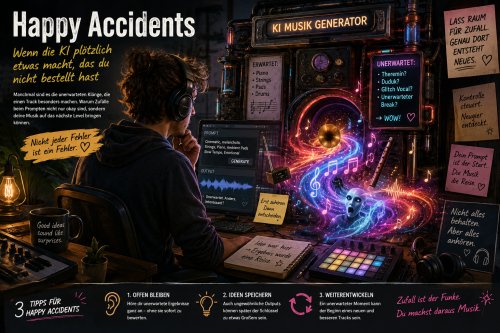
V6-Wild ist deshalb besonders interessant
Suno scheint dieses Problem zumindest konzeptionell selbst zu erkennen. Neben dem normalen V6-Modell gibt es V6-Wild.
Während V6 auf präzise und zuverlässige Ergebnisse ausgerichtet ist, soll Wild laut Suno bewusst experimenteller und weniger vorhersehbar arbeiten. Das Modell soll unerwartete, texturreiche und ambitionierte Ergebnisse liefern. Das ist bemerkenswert.
Denn damit unterscheidet Suno zwischen zwei Eigenschaften, die häufig miteinander verwechselt werden: Kontrolle und Kreativität.
Ein Modell kann sehr gut darin sein, genau das zu produzieren, was man verlangt. Aber genau diese Zuverlässigkeit kann auch dazu führen, dass Überraschungen seltener werden. Vielleicht braucht gute Musik-KI deshalb nicht nur bessere Modelle. Sondern auch Modelle, die bewusst Fehler und Überraschungen zulassen.
Der eigentliche Test kommt erst noch
Noch ist es viel zu früh, aus V6 ein endgültiges Urteil über lizenzierte Trainingsdaten abzuleiten. Dafür ist das Modell zu neu. Die aktuellen Reaktionen stammen überwiegend aus der Community und sind naturgemäß subjektiv. Gleichzeitig gibt es Nutzer, die V6 positiv bewerten oder die Unterschiede anders wahrnehmen.
Was wir aber gerade beobachten können, ist etwas viel Interessanteres: Die Musikindustrie versucht, einen Weg zu finden, bei dem KI mit Zustimmung und Vergütung funktioniert. Suno bewegt sich genau in diese Richtung. Warner und BMG stellen lizenzierte Kataloge zur Verfügung. Believe und TuneCore bieten opt-in-Modelle für Künstler an. Und Suno kündigt zusätzlich Produkte an, bei denen einzelne Künstler selbst entscheiden können, ob und wie ihre Musik in neuen KI-Erfahrungen verwendet wird. Das ist ein Modell, das rechtlich und wirtschaftlich deutlich anders funktioniert als die frühen KI-Systeme.
Doch jetzt kommt die nächste Herausforderung: Kann man eine KI gleichzeitig fair, vielfältig und kreativ trainieren?
Vielleicht braucht die KI mehr als nur die großen Kataloge
Eine mögliche Zukunft wäre deshalb nicht: „Lizenziert oder nicht lizenziert?“ Sondern: „Wie lizenziert und wie vielfältig?“
Ein wirklich vielfältiges Trainingsmodell könnte Musik von großen Labels genauso benötigen wie von Independent-Künstlern, kleinen Labels, Spezialarchiven und Musikern aus Nischen-Genres. Dazu müsste es transparente Lizenzmodelle geben. Künstler müssten freiwillig teilnehmen können. Sie müssten angemessen vergütet werden. Und ihre Musik müsste nicht nur als Rohstoff betrachtet werden, sondern als Teil eines kreativen Ökosystems.
Das wäre möglicherweise der nächste Schritt der KI-Musikindustrie.
Die Zukunft der Musik-KI entscheidet sich nicht nur vor Gericht
Bisher drehte sich die KI-Musikdebatte vor allem um eine Frage: Darf die KI diese Musik überhaupt zum Training verwenden?
Die nächste Frage könnte deutlich komplizierter werden: Welche Musik darf die KI lernen – und wer entscheidet darüber?
Denn eine Welt, in der jedes Trainingssample lizenziert ist, wäre zwar rechtlich möglicherweise sauberer. Aber sie könnte trotzdem kulturelle blinde Flecken erzeugen. Wenn nur die Musik in die Modelle gelangt, die sich einfach lizenzieren lässt, besteht zumindest das Risiko, dass bestimmte Szenen, Genres und Nischen weniger stark repräsentiert werden.
Das wäre dann kein Copyright-Problem. Es wäre ein Vielfaltsproblem. Und genau deshalb sollten wir bei der nächsten Generation von Musik-KI nicht nur fragen: „Ist das legal?“ Sondern auch: „Was fehlt diesem Modell?“
Denn vielleicht entscheidet sich die Zukunft der KI-Musik nicht daran, wie viel Musik sie kennt. Sondern daran, welche Musik sie nicht kennt.
Teilen
Was ist Ihre Reaktion?
 Gefällt mir
0
 Gefällt mir nicht
0
 Liebe
0
 Lustig
0
 Wütend
0
 Traurig
0
 Wow
0